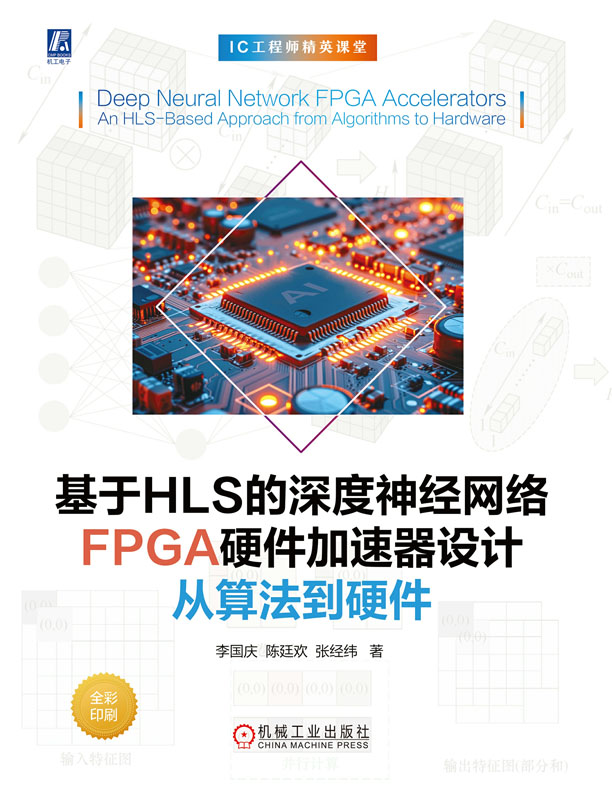


人工智能(AI),特别是深度神经网络(DNN)近年来在计算机视觉、自然语言处理等领域取得了突破性进展,但其庞大的计算需求给传统CPU和GPU架构带来严峻挑战。为满足边缘计算、自动驾驶、智能终端等场景对低延迟、低功耗、高能效的严苛要求,AI硬件加速器已成为产业界与学术界的核心研究方向。本书将高层次综合(HLS)提升为一种核心的协同设计研究工具,为相关领域的研究人员提供了一套标准化、可复现的研究方法论。
《 基于HLS的深度神经网络FPGA硬件加速器设计》通过两个详尽的案例,不仅清晰地展示了深度神经网络硬件加速器的设计过程,更从中提炼出两种具有普遍指导意义的硬件架构范式:计算单元复用式架构——为解决资源受限问题提供了系统性的设计原则与优化策略,是研究高能效比、低成本边缘加速器的典型范本;流水线数据流架构——为追求高吞吐量的应用展示了如何通过精细的流水线设计和数据流调度,最大化硬件并行度与计算效率。从算法模型分析出发,通过HLS进行硬件建模与迭代优化,最终以FPGA为验证平台,能够有效降低设计人员进入“AI加速器设计”这一高门槛领域的难度。
封面
前折页
书名页
版权
前言
学习说明
目录
第1章 深度神经网络基础
1.1 卷积
1.1.1 标准卷积
1.1.2 深度可分离卷积
1.2 池化
1.2.1 最大/平均池化
1.2.2 全局池化
1.2.3 随机池化
1.2.4 自适应池化
1.3 激活
1.3.1 Sigmoid函数
1.3.2 双曲正切函数(Tanh)
1.3.3 线性整流单元(ReLU)
1.3.4 Leaky ReLU
1.3.5 Swish函数
1.3.6 对比总结
1.4 全连接层
1.4.1 全连接层的基本概念和特点
1.4.2 全连接层的作用
1.5 批归一化
1.5.1 批归一化的计算步骤
1.5.2 批归一化的优点和缺点
第2章 经典卷积神经网络
2.1 VGG
2.1.1 VGG特点简介
2.1.2 VGG网络结构
2.1.3 VGG网络的参数量和计算量
2.1.4 VGG网络的优点和缺点
2.2 ResNet
2.2.1 ResNet特点简介
2.2.2 ResNet网络结构
2.2.3 ResNet网络的参数量和计算量
2.2.4 ResNet网络的优缺点
2.3 MobileNetV2
2.3.1 MobileNetV2特点简介
2.3.2 MobileNetV2网络结构
2.3.3 MobileNetV2网络的参数量和计算量
2.3.4 MobileNetV2网络的优点和缺点
2.4 YOLOV2
2.4.1 YOLOV2特点简介
2.4.2 YOLOV2训练过程
2.4.3 YOLOV2网络的优缺点
第3章 神经网络量化
3.1 对称量化与非对称量化
3.1.1 对称量化
3.1.2 非对称量化
3.1.3 量化策略对比总结
3.2 训练后量化与感知量化
3.2.1 训练后量化
3.2.2 感知量化
3.2.3 感知量化与训练后量化对比总结
第4章 神经网络硬件加速理论
4.1 脉动阵列
4.1.1 脉动阵列的结构
4.1.2 数据流
4.1.3 脉动阵列的优点
4.2 基于卷积空间算法的硬件加速方法
4.2.1 循环展开
4.2.2 循环分块
4.2.3 循环交换
4.3 屋顶模型理论
第5章 Vivado HLS介绍
5.1 HLS概述
5.1.1 HLS的功能特点
5.1.2 HLS的优势
5.1.3 术语说明
5.2 数据类型
5.2.1 标准C整数类型
5.2.2 任意精度类型
5.2.3 浮点类型
5.3 基本运算
5.3.1 算术运算符
5.3.2 算术赋值运算符
5.3.3 自增与自减运算符
5.3.4 条件与关系运算符
5.3.5 逻辑与位运算符
5.4 接口类型
5.5 循环优化
5.5.1 变量循环边界
5.5.2 循环流水线化
5.5.3 循环展开
5.5.4 循环并行化
5.5.5 循环依赖关系
5.6 数组优化
5.6.1 HLS中的数组
5.6.2 数组分割
5.6.3 数组重组
5.6.4 数组映射
5.6.5 数组与接口绑定
5.6.6 小结
5.7 函数优化
5.7.1 数据类型优化
5.7.2 函数内联
5.7.3 函数资源共享
5.7.4 数据流优化
第6章 基于Vivado HLS的计算单元复用式深度可分离卷积FPGA加速器设计
6.1 任务分析
6.1.1 数据集
6.1.2 硬件平台
6.1.3 评价标准
6.2 神经网络结构选择
6.3 网络层融合与量化
6.3.1 层融合
6.3.2 量化
6.4 加速器模块划分与代码实现
6.4.1 定义数据类型
6.4.2 模块划分
6.4.3 加载权重与偏置
6.4.4 特征图数据访存
6.4.5 卷积计算引擎
6.4.6 共享计算引擎
6.4.7 其他模块
6.5 集成
6.5.1 接口定义
6.5.2 DWC1+PWC1+POOL1
6.5.3 DWC2+PWC2+POOL2
6.5.4 DWC3
6.5.5 PWC3+POOL3+DWC4
6.5.6 PWC4+DWC5
6.5.7 PWC5+DWC6
6.5.8 REORG+DWC6
6.5.9 PWC6
6.5.10 CONV13与计算边界框
6.6 HLS与Vivado工程
6.6.1 HLS工程
6.6.2 Vivado工程
6.7 上板测试
6.7.1 部署
6.7.2 性能分析
第7章 基于Vivado HLS的流水线结构FPGA加速器设计
7.1 UltraNet网络模型
7.2 加速器设计
7.2.1 模块划分
7.2.2 函数模板
7.2.3 数据处理模块
7.2.4 基于矩阵乘的卷积计算模块
7.2.5 基于DSP2的第一层卷积计算优化
7.2.6 基于DSP6的中间卷积层优化
7.2.7 基于DSP2的最后一层卷积计算优化
7.2.8 池化
7.3 集成
7.3.1 接口定义
7.3.2 顶层集成
7.3.3 流水线平衡
7.4 HLS与Vivado工程
7.5 上板测试
参考文献
后折页
封底
机械工业出版社 京icp备14043556号-1 (署)网出证(京)字第214号 Copyright (C) 2001 CmpBook. All Rights Reserved


 电话
 邮箱
 地址