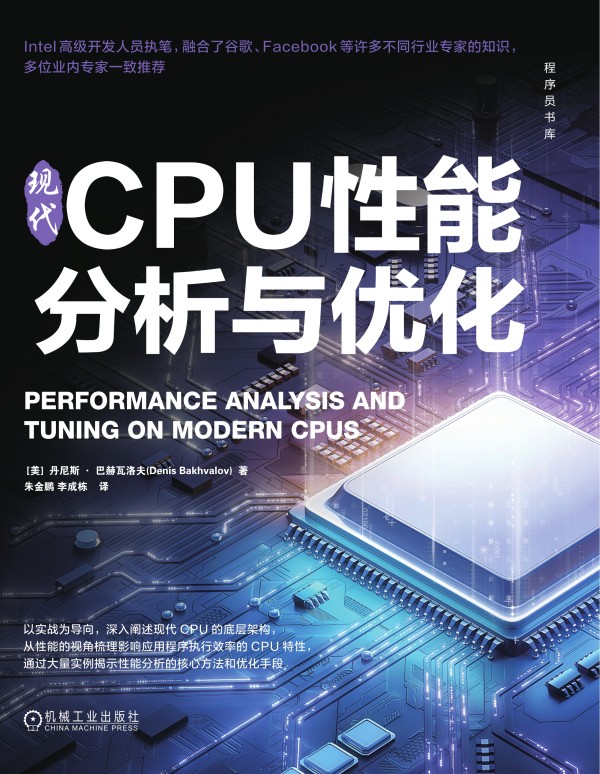


本书旨在指导大家优化运行在现代CPU上的应用程序的性能。具体来说,主要分为两部分内容:
? 第一部分介绍性能分析,包括对CPU微架构、术语和指标的简要概述,还探讨了分析性能的不同方法和现代平台上可用的硬件监控功能。
? 第二部分展示如何发现优化机会,以及可以做哪些转换来提高程序的性能。此外,还提供了一份可应用于用户应用程序的优化清单,包括循环优化、向量化、函数内联等,并讨论了有助于消除CPU微架构层面的问题(如缓存未命中、分支预测错误等)的代码转换。
本书对于从事性能关键型应用程序开发和进行系统底层优化的技术人员来说是不可或缺的。对于任何想更好地了解应用程序性能并探索其诊断和改进方法的开发者来说,这本书也很有用。
封面
前折页
题名页
版权页
译者序
前言
致谢
作者简介
第1章 导读
1.1 为什么需要性能调优
1.2 谁需要做性能调优
1.3 什么是性能分析
1.4 本书的主要内容
1.5 本书不包含什么内容
1.6 本章总结
第一部分 现代CPU性能分析
第2章 性能测量
2.1 现代系统中的噪声
2.2 生产环境中的性能测量
2.3 自动检测性能退化问题
2.4 手动性能测试
2.5 软件计时器和硬件计时器
2.6 微基准测试
2.7 本章总结
第3章 CPU微架构
3.1 指令集架构
3.2 流水线
3.3 利用指令级并行
3.3.1 乱序执行
3.3.2 超标量引擎和超长指令字
3.3.3 投机执行
3.4 利用线程级并行
3.5 存储器层次
3.5.1 高速缓存层次
3.5.2 主存
3.6 虚拟内存
3.7 单指令多数据多处理器
3.8 现代CPU设计
3.8.1 CPU前端
3.8.2 CPU后端
3.9 性能监控单元
第4章 性能分析中的术语和指标
4.1 退休指令与执行指令
4.2 CPU利用率
4.3 CPI和IPC
4.4 微操作
4.5 流水线槽位
4.6 核时钟周期和参考时钟周期
4.7 缓存未命中
4.8 分支预测错误
第5章 性能分析方法
5.1 代码插桩
5.2 跟踪
5.3 负载表征
5.3.1 统计性能事件
5.3.2 手动收集性能计数
5.3.3 事件多路复用和缩放
5.4 采样
5.4.1 用户模式采样和基于硬件事件的采样
5.4.2 寻找热点
5.4.3 采集调用栈
5.4.4 火焰图
5.5 屋顶线性能模型
5.6 静态性能分析
5.7 编译器优化报告
5.8 本章总结
第6章 性能分析相关的CPU特性
6.1 自顶向下微架构分析技术
6.1.1 Intel VTune Profiler中的TMA
6.1.2 Linux perf中的TMA
6.1.3 第一步:确定瓶颈
6.1.4 第二步:定位具体的代码位置
6.1.5 第三步:解决问题
6.1.6 小结
6.2 最后分支记录
6.2.1 采集LBR栈
6.2.2 获取调用图
6.2.3 识别热点分支
6.2.4 分析分支预测错误率
6.2.5 机器码的准确计时
6.2.6 评估分支输出的概率
6.2.7 其他应用场景
6.3 基于处理器事件的采样
6.3.1 精准事件
6.3.2 降低采样开销
6.3.3 分析内存访问
6.4 Intel处理器跟踪技术
6.4.1 工作流
6.4.2 时间报文
6.4.3 采集和解析跟踪文件
6.4.4 用法
6.4.5 磁盘空间和解析时间
6.5 本章总结
第二部分 基于源代码的CPU调优
第7章 CPU前端优化
7.1 机器码布局
7.2 基本块
7.3 基本块布局
7.4 基本块对齐
7.5 函数拆分
7.6 函数分组
7.7 基于剖析文件的编译优化
7.8 对ITLB的优化
7.9 本章总结
第8章 CPU后端优化
8.1 内存绑定
8.1.1 缓存友好的数据结构
8.1.2 显式内存预取
8.1.3 针对DTLB优化
8.2 核心绑定
8.2.1 函数内联
8.2.2 循环优化
8.2.3 向量化
8.3 本章总结
第9章 优化错误投机
9.1 用查表替换分支
9.2 用断言替换分支
9.3 本章总结
第10章 其他调优
10.1 编译时计算
10.2 编译器内建函数
10.3 缓存预热
10.4 减少慢速浮点运算
10.5 系统调优
第11章 优化多线程应用程序
11.1 性能扩展和开销
11.2 并行效率指标
11.2.1 有效CPU利用率
11.2.2 线程数量
11.2.3 等待时间
11.2.4 自旋时间
11.3 使用Intel VTune Profiler进行分析
11.3.1 寻找耗时锁
11.3.2 平台视图
11.4 使用Linux perf进行分析
11.5 使用Coz进行分析
11.6 使用eBPF和GAPP进行分析
11.7 检测一致性问题
11.7.1 缓存一致性协议
11.7.2 真共享
11.7.3 伪共享
11.8 本章总结
附录A 减少测量噪声
附录B LLVM向量化程序
跋
术语
参考文献
推荐阅读
后折页
封底
机械工业出版社 京icp备14043556号-1 (署)网出证(京)字第214号 Copyright (C) 2001 CmpBook. All Rights Reserved


 电话
 邮箱
 地址