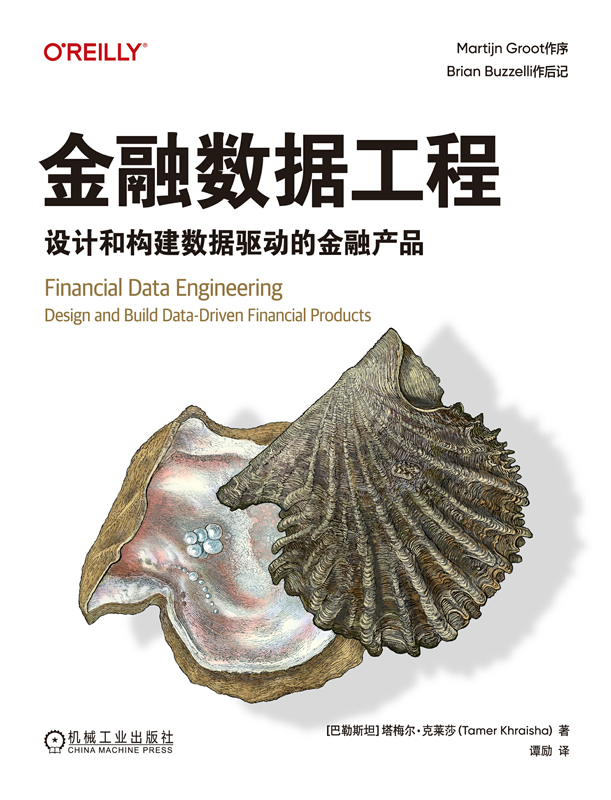


本书分为两部分。第一部分系统阐述金融数据工程定义、生态系统、标识与实体系统、数据治理等核心理论,夯实知识基础;第二部分聚焦数据工程全生命周期,详解摄入、存储、转换等各环节技术要点与实践方法。书中涵盖多类型金融数据、技术栈构建逻辑及4个典型实操项目,兼顾理论深度与应用场景,可有效助力读者全面掌握金融数据工程核心技能,适配学习与工作需求。本书适合寻求数据驱动金融服务见解的从业者、研究金融相关问题的学者,以及渴望以技术为导向进入金融领域的新人阅读。
封面
书名页
版权页
O'Reilly Media,Inc.介绍
本书赞誉
译者序
目录
序
前言
第一部分 金融数据工程基础
第1章 金融数据工程释义
1.1 金融数据工程的定义
1.1.1 什么是金融
1.1.2 数据工程的定义
1.1.3 金融数据工程的定义
1.2 为什么是金融数据工程
1.2.1 金融数据的三大特征:规模、速率和多样性
1.2.2 金融领域的数据特征和难点
1.2.3 金融机器学习
1.2.4 颠覆性的金融科技格局
1.2.5 监管要求和合规性
1.3 金融数据工程师的角色
1.3.1 角色描述
1.3.2 金融数据工程师的工作环境
1.3.3 金融数据工程师的职责范围和工作内容
1.3.4 金融数据工程师的技能
1.4 总结
第2章 金融数据生态系统
2.1 金融数据的来源
2.1.1 公共金融数据
2.1.2 证券交易所
2.1.3 金融数据商、服务提供商及分销机构
2.1.4 调查数据
2.1.5 另类数据
2.1.6 机密和专有数据
2.2 金融数据的结构
2.2.1 时间序列数据
2.2.2 横截面数据
2.2.3 面板数据
2.2.4 矩阵数据
2.2.5 图数据
2.2.6 文本数据
2.3 金融数据类型
2.3.1 基本面数据
2.3.2 市场数据
2.3.3 交易数据
2.3.4 分析数据
2.3.5 另类数据
2.3.6 参考数据
2.3.7 实体数据
2.4 基准金融数据集
2.4.1 证券价格研究中心
2.4.2 Compustat财务数据
2.4.3 交易和报价数据库
2.4.4 机构经纪人估值系统
2.4.5 期权交易公司艾维数据库
2.4.6 交易报告和合规引擎
2.4.7 奥比斯全球数据库
2.4.8 SDC铂金数据库
2.4.9 标准普尔道琼斯指数
2.4.10 另类数据集
2.5 总结
第3章 金融标识系统
3.1 金融标识符
3.1.1 金融标识符与标识系统的定义
3.1.2 金融标识符的必要性
3.1.3 谁创建金融标识系统
3.2 金融标识符的理想属性
3.2.1 唯一性
3.2.2 全局性
3.2.3 可扩展性
3.2.4 完整性
3.2.5 可访问性
3.2.6 时效性
3.2.7 可靠性
3.2.8 粒度
3.2.9 永久性
3.2.10 不可变性
3.2.11 安全性
3.3 金融标识系统概况
3.3.1 国际证券标识码
3.3.2 金融工具分类代码
3.3.3 金融工具简称
3.3.4 统一证券标识程序委员会
3.3.5 法人实体识别编码
3.3.6 交易标识符
3.3.7 证券交易所每日官方清单
3.3.8 股票代码
3.3.9 衍生品标识符
3.3.10 金融工具全球标识符
3.3.11 FactSet永久标识符
3.3.12 LSEG永久标识符
3.3.13 数字资产标识符
3.3.14 行业和部门标识符
3.3.15 银行标识符
3.4 总结
第4章 金融实体系统
4.1 金融实体的定义
4.2 金融命名实体识别
4.2.1 命名实体识别描述
4.2.2 命名实体识别是如何工作的
4.2.3 命名实体识别方法
4.2.4 命名实体识别软件库
4.3 金融实体解析
4.3.1 实体解析描述
4.3.2 金融领域中实体消歧的重要性
4.3.3 实体解析如何工作
4.3.4 实体解析的方法
4.3.5 实体解析软件库
4.4 总结
第5章 金融数据治理
5.1 金融数据治理概述
5.1.1 金融数据治理的定义
5.1.2 金融数据治理的合理性
5.2 数据质量
5.2.1 维度1:数据错误
5.2.2 维度2:数据离群值
5.2.3 维度3:数据偏差
5.2.4 维度4:数据粒度
5.2.5 维度5:数据重复
5.2.6 维度6:数据可用性与完整性
5.2.7 维度7:数据时效性
5.2.8 维度8:数据约束
5.2.9 维度9:数据相关性
5.3 数据完整性
5.3.1 原则1:数据标准
5.3.2 原则2:数据备份
5.3.3 原则3:数据归档
5.3.4 原则4:数据聚合
5.3.5 原则5:数据血缘
5.3.6 原则6:数据目录
5.3.7 原则7:数据所有权
5.3.8 原则8:数据合同
5.3.9 原则9:数据核对
5.4 数据安全与隐私
5.4.1 数据隐私
5.4.2 数据匿名化
5.4.3 数据加密
5.4.4 访问控制
5.5 总结
第二部分 金融数据工程生命周期
第6章 金融数据工程全生命周期综述
6.1 金融数据工程生命周期的定义
6.2 构建金融数据工程技术栈的准则
6.2.1 标准1:开源软件与商业软件
6.2.2 标准2:易用性与性能
6.2.3 标准3:本地部署与云计算
6.2.4 标准4:公有云、私有云和混合云
6.2.5 标准5:单一云与多云
6.2.6 标准6:单体式与模块化代码库
6.3 总结
第7章 数据摄入层
7.1 数据传输和到达流程
7.1.1 数据传输协议
7.1.2 数据到达流程
7.2 数据摄入格式
7.2.1 通用格式
7.2.2 大数据格式
7.2.3 内存格式
7.2.4 标准化的金融格式
7.3 数据摄入技术
7.3.1 金融API
7.3.2 金融数据流
7.3.3 安全文件传输
7.3.4 云访问
7.3.5 网络访问
7.3.6 专业金融软件
7.4 数据摄入最佳实践
7.4.1 满足业务需求
7.4.2 为变化而设计
7.4.3 实施数据治理
7.4.4 进行基准测试和压力测试
7.5 总结
第8章 数据存储层
8.1 数据存储系统设计原则
8.1.1 原则1:业务需求
8.1.2 原则2:数据建模
8.1.3 原则3:事务保障
8.1.4 原则4:一致性权衡
8.1.5 原则5:可扩展性
8.1.6 原则6:安全性
8.2 数据存储建模
8.2.1 SQL与NoSQL
8.2.2 主存储与次存储
8.2.3 操作型与分析型
8.2.4 原生与非原生
8.2.5 多模型与多语言持久化
8.3 数据存储模型
8.3.1 数据湖模型
8.3.2 关系模型
8.3.3 文档模型
8.3.4 时间序列模型
8.3.5 消息代理模型
8.3.6 图模型
8.3.7 仓库模型
8.3.8 区块链模型
8.4 总结
第9章 数据转换与交付层
9.1 数据查询
9.1.1 查询模式
9.1.2 查询优化
9.2 数据转换
9.2.1 转换操作
9.2.2 转换模式
9.2.3 计算需求
9.3 数据交付
9.3.1 数据消费者
9.3.2 交付机制
9.4 总结
第10章 监控层
10.1 指标、事件、日志和跟踪
10.1.1 指标
10.1.2 事件
10.1.3 日志
10.1.4 跟踪
10.2 数据质量监控
10.3 性能监控
10.4 成本监控
10.5 业务和分析监控
10.6 数据可观测性
10.7 总结
第11章 金融数据工作流
11.1 面向工作流的软件架构
11.2 什么是数据工作流
11.3 工作流管理系统
11.3.1 灵活性
11.3.2 可配置性
11.3.3 依赖管理
11.3.4 协调模式
11.3.5 可扩展性
11.3.6 集成性
11.4 金融数据工作流的类型
11.4.1 提取—转换—加载工作流
11.4.2 流处理工作流
11.4.3 微服务工作流
11.4.4 机器学习工作流
11.5 总结
第12章 实践项目
12.1 前提条件
12.2 项目1:基于PostgreSQL开发银行账务管理系统
12.2.1 概念模型:业务需求
12.2.2 逻辑模型:实体关系图
12.2.3 物理模型:数据定义语言和数据操作语言
12.2.4 项目1:本地测试
12.2.5 项目1:清理
12.2.6 项目1:总结
12.3 项目2:基于Mage和Python设计金融数据ETL流程
12.3.1 项目2:工作流定义
12.3.2 项目2:数据库设计
12.3.3 项目2:本地测试
12.3.4 项目2:清理
12.3.5 项目2:总结
12.4 项目3:基于Netflix Conductor、PostgreSQL和Python设计微服务工作流
12.4.1 项目3:工作流定义
12.4.2 项目3:数据库设计
12.4.3 项目3:本地测试
12.4.4 项目3:清理
12.4.5 项目3:总结
12.5 项目4:基于OpenFIGI、PermID和GLEIF API设计金融参考数据库
12.5.1 项目4:先决条件
12.5.2 项目4:本地测试
12.5.3 项目4:清理
12.5.4 项目4:总结
12.6 结论
12.7 关注这些项目的更新
12.8 报告问题或提问
前进的道路 塑造金融市场的趋势
后记
推荐阅读
封底
机械工业出版社 京icp备14043556号-1 (署)网出证(京)字第214号 Copyright (C) 2001 CmpBook. All Rights Reserved


 电话
 邮箱
 地址