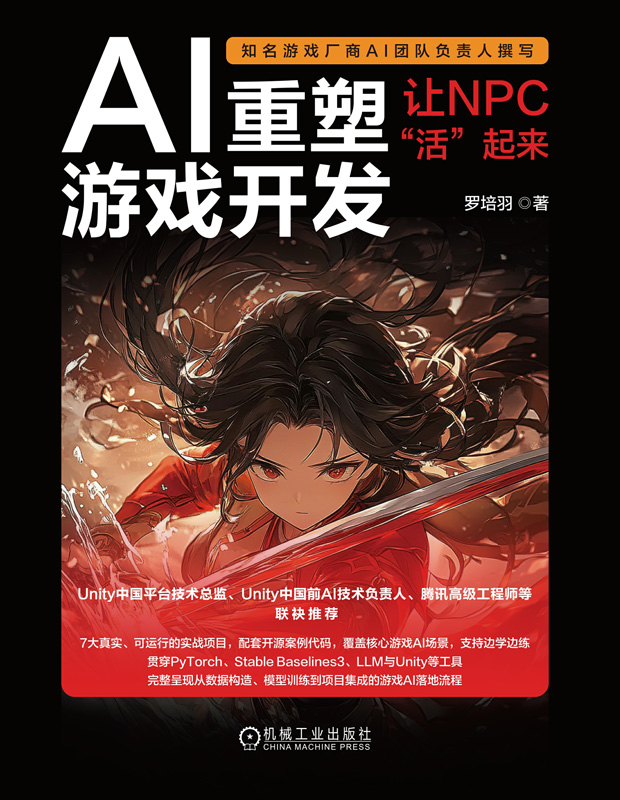




作为知名游戏厂商AI团队负责人,作者将自己多年在游戏领域的AI探索经验和盘托出,以真实的游戏项目案例,系统讲解AI技术从数据构造、模型训练到游戏工程集成的完整实践路径,回答“如何将AI真正做进游戏”这个核心问题。
?首先讲解基础建模,以玩家战斗力预测和AI捏脸为案例,介绍PyTorch、神经网络、数据集、模型训练与推理,并完整实现从数据生成、人脸关键点提取到模型集成的AI捏脸流程。
?然后聚焦强化学习,以网格寻路和三消关卡生成为案例,讲解状态空间、动作空间、奖励函数、智能体训练、环境向量化等关键技术,展示如何利用强化学习辅助游戏生产。
?最后深入综合应用,涵盖LLM驱动的智能NPC与AI队友、基于遗传算法和强化学习的阵容平衡与推荐,以及基于MediaPipe和Unity的视频动作生成。
本书以Python和Unity为主要开发工具,但聚焦AI技术落地游戏开发的一般性方法,同样适用于使用其他技术栈的项目。本书适合有一定游戏开发基础、希望学习AI技术的游戏开发程序员,有志进入游戏行业的AI工程师,以及游戏公司新人、高校学生、独立游戏开发者等所有对AI游戏感兴趣的读者。书中所有示例源码与素材均通过GitHub开源提供,可边学边练。
封面
前折页
书名页
版权页
前言
目录
第1章 从战斗力预测开始入门模型设计
1.1 从战斗力预测开始
1.1.1 解读游戏场景
1.1.2 理解AI的数据基础——张量
1.1.3 构建输入-输出模型
1.1.4 计算损失函数和梯度
1.1.5 循环训练
1.1.6 模型推理
1.2 数据集处理
1.2.1 分析业务数据
1.2.2 自定义数据集
1.2.3 数据加载器
1.2.4 升级多维输入-输出模型
1.2.5 升级双重循环训练
1.3 战斗匹配系统
1.3.1 收集线上玩家属性
1.3.2 构造ELO排行数据
1.4 模型结构与生态
1.4.1 卷积网络扩展二维特征
1.4.2 ResNet支撑深层网络
1.4.3 自注意力Transformer架构
1.4.4 常用的第三方库
1.5 总结
第2章 AI驱动的照片捏脸系统
2.1 解读游戏场景
2.2 关键技术原理
2.3 开发捏脸模拟器
2.3.1 制作三维模型
2.3.2 定义捏脸数据
2.3.3 模型形变控制
2.3.4 头发类型控制
2.3.5 用户交互界面
2.3.6 提取面部关键点
2.4 数据集和归一化
2.4.1 数据集生成
2.4.2 人脸关键点归一化
2.5 脸型参数预测
2.5.1 神经网络结构的设计
2.5.2 数据集类的实现
2.5.3 训练器的实现
2.5.4 预测器的实现
2.6 与真实人脸的风格化对齐
2.6.1 提取真实人脸的关键点
2.6.2 统计分析风格化的差异
2.7 发型分类器的构建
2.7.1 数据集的准备
2.7.2 数据集类的实现
2.7.3 卷积神经网络模型的设计
2.7.4 训练器的实现
2.7.5 预测器的实现
2.8 发型分类器的调优
2.8.1 解决数据类别不均衡问题
2.8.2 解决训练数据不足问题
2.8.3 使用预训练模型进行迁移学习
2.9 管线整合
2.10 总结
第3章 在网格寻路中入门强化学习
3.1 解读游戏场景
3.2 关键技术原理
3.3 开发网格寻路游戏
3.3.1 设定游戏状态
3.3.2 创建地图
3.3.3 动作执行
3.3.4 实现游戏主循环
3.4 基础的强化学习训练
3.4.1 标准强化学习环境的三要素
3.4.2 动作空间和观测空间
3.4.3 奖励函数
3.4.4 训练模型
3.4.5 评估效果
3.5 奖励函数的优化
3.5.1 分析训练失败的原因
3.5.2 奖励函数的改进
3.5.3 验证智能体玩游戏的效果
3.6 四种进阶技术
3.6.1 使用TensorBoard监控训练
3.6.2 Stable Baselines3同时运行多个环境
3.6.3 回调训练过程的数据监控
3.6.4 自定义网络结构
3.7 总结
第4章 三消游戏关卡的智能生成
4.1 解读游戏场景
4.2 关键技术原理
4.3 开发基础版三消游戏
4.3.1 定义基础配置
4.3.2 实现核心逻辑
4.3.3 实现交互逻辑
4.3.4 匹配和消除
4.3.5 人工测试
4.4 开发游戏智能体
4.4.1 基于贪婪策略的决策逻辑
4.4.2 自动化的流程评估
4.5 强化学习生成关卡
4.5.1 环境类设计
4.5.2 动作空间
4.5.3 状态表示与观测空间
4.5.4 动作执行
4.5.5 奖励函数设计
4.5.6 实现训练器
4.5.7 制作关卡生成器
4.6 模型泛化能力的优化
4.6.1 生成多种难度关卡
4.6.2 扩展棋盘尺寸
4.6.3 关键参数调优
4.6.4 改进奖励机制
4.7 总结
第5章 可交互的智能NPC
5.1 解读游戏场景
5.2 关键技术原理
5.2.1 消息处理流程
5.2.2 接入通义模型
5.2.3 游戏系统说明
5.3 搭建LLM通信基础
5.3.1 定义API数据结构
5.3.2 实现HTTP通信客户端
5.3.3 验证第一轮对话
5.4 实现闲聊功能
5.4.1 扩展闲聊通信接口
5.4.2 角色性格塑造
5.4.3 对话记忆管理
5.4.4 识别目标角色
5.4.5 整合对话流程
5.5 理解动作指令
5.5.1 Function Calling技术
5.5.2 意图识别
5.5.3 游戏动作封装
5.5.4 工具注册和管理
5.5.5 收集场景信息
5.5.6 整合所有流程
5.6 总结
第6章 考量平衡性的阵容挖掘与推荐
6.1 解读游戏场景
6.2 关键技术原理
6.3 开发对战模拟器
6.3.1 战斗功能概览
6.3.2 核心类结构设计
6.3.3 HTTP API
6.3.4 HTTP客户端
6.4 基于遗传算法的阵容挖掘
6.4.1 队伍个体的设计
6.4.2 遗传算法的主体实现
6.4.3 适应度函数的基础设计
6.4.4 “轮盘赌”和“锦标赛”的选择策略
6.4.5 交叉和变异
6.4.6 进化流程的整合
6.4.7 挖掘效果的验证
6.4.8 适应度函数的优化设计
6.4.9 动态的教练队伍机制
6.5 基于强化学习的阵容推荐
6.5.1 转化为序列决策问题
6.5.2 环境设计
6.5.3 状态空间表示
6.5.4 动作空间表示
6.5.5 单步执行与状态转移
6.5.6 奖励函数设计
6.5.7 预测器与实时推荐
6.5.8 模型训练和效果验证
6.5.9 强化学习中的动态教练机制
6.5.10 应对有限英雄池的挑战
6.6 总结
第7章 视频动作生成
7.1 解读游戏场景
7.2 关键技术原理
7.3 提取姿态关键点
7.3.1 构建姿态提取器
7.3.2 直接导入骨骼位置的错误示范
7.4 用LookRotation控制骨骼方向
7.4.1 基础旋转控制
7.4.2 让y轴指向目标方向
7.4.3 手臂骨骼控制
7.5 读取MediaPipe姿态数据
7.5.1 定义MediaPipe数据结构
7.5.2 实现数据读取器
7.5.3 实现姿态可视化
7.6 Unity骨骼控制动画
7.6.1 设计骨骼旋转计算的代码框架
7.6.2 实现右臂的骨骼控制
7.6.3 建立动画播放系统
7.6.4 实现腿部的骨骼控制
7.6.5 实现躯干的骨骼控制
7.7 动画优化与适配
7.7.1 平滑插值优化
7.7.2 角色位置调整
7.7.3 骨骼旋转约束
7.7.4 任意3D模型适配
7.8 AI姿态检测的技术原理
7.9 总结
第8章 未来之路
8.1 智能资源生产
8.2 软件工程模式创新
8.3 游戏自动推演及调优
8.4 游戏引擎重构
8.5 总结
后记
后折页
封底
机械工业出版社 京icp备14043556号-1 (署)网出证(京)字第214号 Copyright (C) 2001 CmpBook. All Rights Reserved


 电话
 邮箱
 地址